Robots.txt e llms.txt: cosa sono e come gestire i crawler AI

laura.oppizio@eskimoz.it
Per anni il file robots.txt è stato un dettaglio tecnico da sistemare una volta e poi dimenticare.
Con l’arrivo di ChatGPT, Claude, Perplexity e Gemini è tornato al centro delle scelte SEO. Oggi un sito non riceve solo le visite di Googlebot, ma anche quelle di decine di crawler AI con funzioni diverse: alcuni raccolgono contenuti per addestrare i modelli, altri alimentano i motori di risposta, altri ancora visitano una pagina su richiesta di un utente.
Decidere chi far entrare e chi no ha delle dirette conseguenze sulla visibilità, sia su Google sia nelle risposte generate dall’IA.
Cos’è il file robots.txt
Il robots.txt è un file di testo che contiene regole per stabilire quali crawler possono accedere a determinate parti di un sito. In altre parole, dice ai bot dove non entrare. I crawler di Google supportano il protocollo di esclusione robot (REP), definito dallo standard RFC 9309: prima di scansionare un sito, scaricano e analizzano il robots.txt per capire quali sezioni possono visitare.
Un esempio di file è:
# https://www.esempio.it/robots.txt
User-agent: *
Disallow: /ricerca/
Disallow: /*?colore=

Sitemap: https://www.esempio.it/sitemap_index.xml
In queste poche righe il sito chiede a tutti i crawler di non visitare due tipi di URL: le pagine della ricerca interna e quelle generate dal filtro colore. Indica poi dove si trova la sitemap.
Le istruzioni del robots.txt però sono richieste, non obblighi. Spetta al crawler decidere se rispettarle: Googlebot e gli altri crawler affidabili lo fanno, ma non è detto che tutti si comportino allo stesso modo. Per proteggere davvero un contenuto si consigliano altri metodi, come ad esempio la protezione tramite password.
Che cosa fa il robots.txt
Il robots.txt si trova sempre allo stesso indirizzo, cioè il dominio seguito da /robots.txt, e indica ai bot quali percorsi non devono richiedere.
Serve principalmente a gestire il traffico dei crawler ed evitare che il sito venga sovraccaricato di richieste.
È soprattutto la leva principale sul crawl budget, cioè sull’insieme di URL che Google può e vuole scansionare. Le URL bloccate non vengono scaricate dai crawler che rispettano il file, e quindi non compaiono nemmeno nei log del server.
Per questo si suggerisce di bloccare con il robots.txt le pagine poco importanti per la ricerca, quando non è possibile consolidarle in altro modo. Un dettaglio da sapere: le URL bloccate restano più a lungo nella coda di scansione e vengono riscansionate quando il blocco viene rimosso.
Nella pratica SEO il file viene usato per:
- concentrare la scansione sulle pagine che contano;
- escludere aree senza valore per la ricerca, come carrello, area riservata, risultati della ricerca interna o combinazioni di filtri;
- dichiarare dove si trova la sitemap.
Che cosa non fa il robots.txt
Non toglie una pagina da Google. Il file non è un meccanismo per escludere una pagina web dai risultati: un URL bloccato può comparire comunque nei risultati, senza descrizione, se altri siti lo linkano. Per escludere una pagina servono il meta tag noindex o la protezione tramite password.
Non è uno strumento di canonicalizzazione. Infatti il robots.txt non va usato per indicare la versione preferita di pagine duplicate, perché Google può comunque indicizzare URL bloccati, senza il loro contenuto. Per gestire i duplicati si usano il tag rel=”canonical”, i reindirizzamenti o la sitemap.
Scansione e indicizzazione sono due fasi distinte: il robots.txt agisce sulla prima, cioè sulla visita della pagina da parte del crawler, mentre il noindex agisce sulla seconda, cioè sull’inclusione nei risultati. Per approfondire, la nostra guida su come indicizzare un sito su Google ricostruisce l’intero processo.
Dove si trova e come leggerlo
Il file deve trovarsi nella directory di primo livello del sito, ad esempio https://www.esempio.it/robots.txt. Per leggerlo basta aprire questo indirizzo nel browser.
Esistono alcune regole tecniche:
- Un file per host. Le regole valgono solo per l’host, il protocollo e il numero di porta su cui il file è ospitato, quindi un robots.txt su un sottodominio vale solo per quel sottodominio.
- Mai in una sottocartella. Un file posizionato in una sottodirectory non è valido, perché i crawler non lo cercano lì.
- Formato. Il file deve essere testo normale codificato in UTF-8.
- Dimensione massima. Google applica un limite di 500 KiB e ignora i contenuti che lo superano.
Sintassi del robots.txt
User-agent, Disallow e Allow
Google supporta quattro campi:
user-agentidentifica il crawler a cui si applicano le regole;allowindica un percorso che può essere scansionato;disallowindica un percorso che non può essere scansionato;sitemapcontiene l’URL completo di una sitemap.
User-agent: *
Disallow: /area-riservata/
Allow: /area-riservata/documenti-pubblici/
L’asterisco nella riga User-agent si rivolge a tutti i crawler. I nomi dei campi non distinguono tra maiuscole e minuscole, ma i valori dei percorsi sì: /Prodotti e /prodotti sono due percorsi diversi.
Quando due regole sono in conflitto, Google applica la più specifica, cioè quella con il percorso più lungo. A parità di specificità, usa la regola meno restrittiva.
Un dettaglio genera molti errori. Per ogni crawler vale un solo gruppo di regole: quello con lo user agent più specifico, mentre gli altri vengono ignorati. I gruppi dedicati a uno user agent specifico e il gruppo globale * non vengono combinati.
Se nel file esiste un gruppo dedicato a un bot, quel bot ignora le regole generali. Chi crea un gruppo dedicato deve quindi ripetervi tutte le esclusioni che vuole far valere anche per quel crawler.
Sitemap e caratteri jolly
Il campo Sitemap deve contenere un URL completo di protocollo e host. Non deve necessariamente trovarsi sullo stesso host del robots.txt, e si possono indicare più sitemap senza limiti di numero.
Per scrivere regole più compatte si usano i caratteri jolly, supportati da Google, Bing e dai principali motori di ricerca: l’asterisco * corrisponde a zero o più caratteri, mentre il simbolo $ indica la fine dell’URL.
User-agent: *
Disallow: /?filtro=
Disallow: /.pdf$
Sitemap: https://www.esempio.it/sitemap.xml
Un’ultima precisazione riguarda la direttiva Crawl-delay, presente in molti file robots.txt. Google non la supporta, quindi la riga non ha alcun effetto su Googlebot. Anthropic, invece, la supporta per i propri bot come estensione non standard.
Esempi di configurazione
WordPress
Se il sito non ha un file fisico, WordPress genera automaticamente un robots.txt virtuale simile a questo:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Sitemap: https://www.esempio.it/wp-sitemap.xml
Per modificarlo si può caricare un file fisico nella root, che prende il posto di quello virtuale, oppure usare un plugin SEO come Yoast o Rank Math. La riga Allow su admin-ajax.php serve a non bloccare risorse che alcune pagine usano per funzionare.
E-commerce
Su un catalogo con filtri e ordinamenti, il robots.txt aiuta a non disperdere la scansione su migliaia di combinazioni di URL simili:
User-agent: *
Disallow: /carrello/
Disallow: /checkout/
Disallow: /?ordina=
Disallow: /?s=
Sitemap: https://www.esempio.it/sitemap.xml
In questo esempio vengono escluse le pagine di carrello e checkout, che non hanno valore per la ricerca, le varianti di ordinamento che duplicano le pagine di categoria e i risultati della ricerca interna.
Robots.txt e crawler AI
Crawler di training, di ricerca e agenti
I crawler AI si dividono in tre famiglie, e la distinzione è il cuore di ogni strategia:
- Training: raccolgono contenuti che possono essere usati per addestrare i modelli. Bloccarli non riduce la visibilità nelle risposte.
- Ricerca: costruiscono l’indice da cui i motori di risposta attingono per citare le fonti. Bloccarli significa sparire da quelle risposte.
- Agenti e fetch su richiesta: visitano una pagina quando un utente lo chiede. Per loro il robots.txt ha un effetto limitato.
Sull’ultima famiglia le aziende sono esplicite:
- OpenAI precisa che per ChatGPT-User, attivato dalle azioni degli utenti, le regole del robots.txt potrebbero non applicarsi.
- Perplexity dichiara che Perplexity-User in genere ignora queste regole.
- Google indica che i suoi fetcher attivati dagli utenti, tra cui Google-Agent, generalmente ignorano il robots.txt.
GPTBot, ClaudeBot, PerplexityBot e Google-Extended
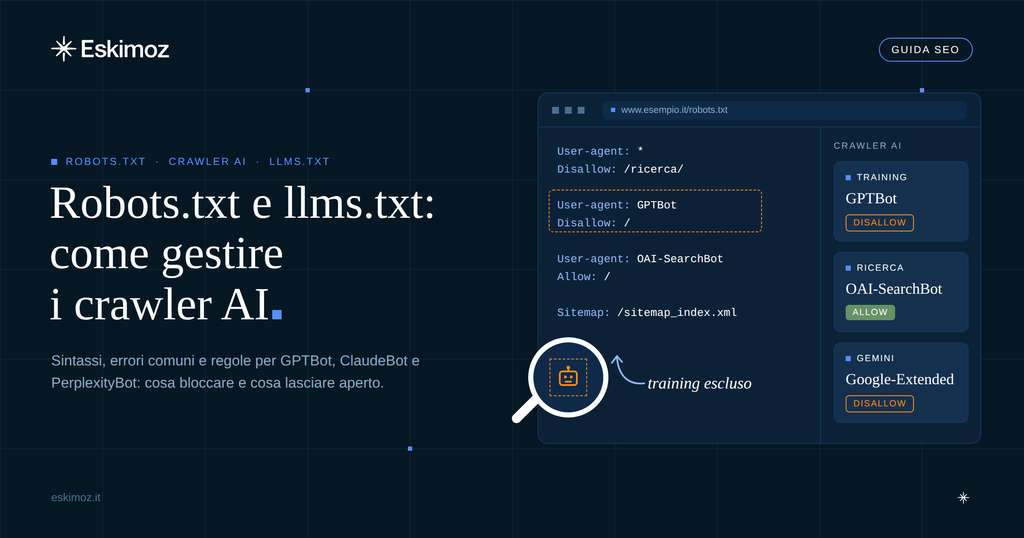
- OpenAI gestisce due tag distinti nel robots.txt: OAI-SearchBot e GPTBot.
OAI-SearchBot serve a far comparire i siti tra i risultati delle funzioni di ricerca di ChatGPT, ed è il tag da usare per gestire l’opt-out dalla ricerca. - Anthropic segue la stessa logica: disattivare Claude-SearchBot impedisce l’indicizzazione dei contenuti per la ricerca e può ridurre la visibilità del sito nelle risposte. I bot di Anthropic rispettano le direttive standard del robots.txt. L’azienda precisa anche che bloccarne gli indirizzi IP può non garantire un opt-out efficace, perché impedisce di leggere il robots.txt.
- Perplexity raccomanda di consentire PerplexityBot nel robots.txt per comparire nei risultati di ricerca. Perplexity-User non viene usato per la scansione del web né per raccogliere contenuti destinati all’addestramento dei modelli.
- Google-Extended è un caso a parte, perché non ha uno user agent proprio: la scansione avviene con gli user agent esistenti di Google e il token viene letto solo come controllo. Stabilisce se i contenuti scansionati possono essere usati per addestrare le future generazioni dei modelli Gemini e per il grounding delle risposte nelle app Gemini e in Vertex AI. In ogni caso, Google-Extended non incide sull’inclusione del sito nella Ricerca Google e non è un segnale di ranking.
Una configurazione diffusa, per chi vuole restare citabile senza mettere i contenuti a disposizione del training, è questa:
User-agent: GPTBot
Disallow: /
User-agent: ClaudeBot
Disallow: /
User-agent: Google-Extended
Disallow: /
User-agent: OAI-SearchBot
Allow: /
User-agent: Claude-SearchBot
Allow: /
User-agent: PerplexityBot
Allow: /
Non esiste però una configurazione valida per tutti. La scelta dipende dal modello di business:
- Editori e siti di contenuti originali possono avere interesse a escludere il training, mantenendo aperti i crawler di ricerca.
- E-commerce e aziende di servizi hanno spesso interesse a lasciare aperti i crawler di ricerca per essere raccomandati nelle risposte.
- Siti con aree riservate o contenuti premium devono proteggerli con l’autenticazione, non con il robots.txt.
La decisione va presa caso per caso, tenendo conto della strategia GEO del sito.
Le nuove regole Cloudflare sui bot
Per molti siti la gestione dei crawler AI non passa più solo dal robots.txt, ma anche dalla CDN. A settembre 2026 Cloudflare ha introdotto la designazione “Accountable” per i crawler AI e, insieme, l’impostazione Disallow AI Training. Questa opzione permette a un sito di rifiutare l’addestramento AI restando pienamente presente nei risultati di ricerca.
Il problema che risolve riguarda i crawler misti, cioè quelli che raccolgono contenuti sia per un indice di ricerca sia per il training. Secondo Cloudflare, fino a quel momento rifiutare il training significava perdere anche la ricerca dei crawler privi di controlli adeguati. Per ottenere la designazione Accountable, ogni operatore deve inoltre offrire ai proprietari dei siti un modo per escludersi dai riassunti AI.
Cloudflare ha poi sostituito l’interruttore unico “Block AI Bots” con tre controlli indipendenti: ricerca, training e agenti AI.
Le impostazioni predefinite cambiano in base al tipo di sito:
- Siti con pubblicità: la scansione per la ricerca è attiva, il training è escluso e gli agenti AI sono bloccati sulle pagine con annunci.
- Tutti gli altri siti: ricerca, training e agenti sono consentiti.
Per i siti che usano Cloudflare, quindi, un robots.txt perfetto non basta. Le impostazioni della CDN vanno verificate con la stessa attenzione, controllando che i crawler di ricerca, compresi Googlebot e Bingbot, non risultino bloccati e che le regole siano coerenti con quelle del robots.txt.
Cos’è il file llms.txt
Come funziona e cosa contiene
Il file llms.txt è una proposta di Jeremy Howard per standardizzare un file che aiuti i modelli linguistici a usare un sito al momento della risposta. Si tratta di un file in formato Markdown, collocato nel percorso /llms.txt, che offre brevi informazioni di contesto, indicazioni e link a file Markdown più dettagliati.
La differenza con il robots.txt è netta. Il robots.txt dice ai crawler dove possono andare; llms.txt prova a dire ai modelli cosa leggere. Non è uno strumento per autorizzare o bloccare l’accesso. La proposta stessa, del resto, non indica alcun modo specifico in cui il file debba essere elaborato, lasciando la scelta alle singole applicazioni.
Lo stato dell’adozione
Per la ricerca Google la risposta è ufficiale. Google ha chiarito che creare e mantenere file llms.txt per altri servizi è del tutto accettabile, ma non aiuta né danneggia la visibilità o il ranking nella ricerca Google, perché la ricerca li ignora.
Questo vale anche per AI Overviews e AI Mode, che fanno parte della ricerca Google. Per gli altri motori di risposta, nessuna delle principali aziende AI ha finora indicato ufficialmente llms.txt come segnale usato dai propri crawler di ricerca.
Errori comuni nel robots.txt
Bloccare CSS e JavaScript
Google consente di bloccare file di risorse come script e fogli di stile solo se la pagina, senza di essi, non perde nulla di significativo. Se invece la loro assenza rende più difficile la comprensione della pagina, non vanno bloccati: Google non potrebbe analizzare correttamente le pagine che dipendono da quelle risorse.
Regole come Disallow: /wp-content/ o Disallow: /*.js$, ancora presenti in molti file datati, vanno quindi rimosse.
Usare Disallow per deindicizzare
È l’errore più diffuso. Una pagina bloccata dal robots.txt può comunque essere indicizzata se altre pagine del web vi rimandano. In quel caso nei risultati possono comparire l’URL e l’anchor text dei link in entrata. Google, infatti, non indicizza i contenuti di una pagina bloccata, ma può comunque indicizzarne l’URL e mostrarlo senza snippet.
C’è anche un effetto paradossale: se una pagina ha il meta tag noindex ma è bloccata dal robots.txt, Google non può scansionarla e quindi non vede mai il noindex.
La procedura corretta per rimuovere una pagina da Google segue tre passaggi:
- applicare il meta tag noindex lasciando la pagina scansionabile;
- attendere che Google la scansioni e la rimuova dall’indice;
- solo a quel punto valutare se bloccarla anche nel robots.txt.
Altri errori ricorrenti riguardano invece il contenuto e il codice di risposta del file:
- Il
Disallow: /dimenticato dopo il lancio: È tipico di un ambiente di staging messo online senza rimuovere il blocco. - Errori 4xx: Google tratta tutti gli errori 4xx, tranne il 429, come se il file non esistesse, quindi senza alcuna restrizione di scansione.
- Errori 5xx: Nelle prime 12 ore Google interrompe la scansione del sito. Per i 30 giorni successivi usa l’ultima versione valida memorizzata.
- Troppi reindirizzamenti: Google segue almeno cinque reindirizzamenti; oltre questa soglia tratta il robots.txt come un errore 404.
Come testare il robots.txt
Dopo ogni modifica, il primo controllo è aprire il file nel browser e verificare che le regole siano scritte come previsto.
Il controllo successivo passa da Google Search Console. Il report dedicato al robots.txt mostra le regole interpretate da Google ed eventuali avvisi; lo strumento Controllo URL indica invece se una singola pagina è bloccata dal file.
Una modifica non ha effetto immediato: Google conserva in cache il robots.txt in genere per un massimo di 24 ore.
Per i crawler AI, il riscontro più affidabile resta l’analisi dei log del server, che mostra quali bot visitano davvero il sito e quali pagine richiedono. Va ricordato che uno user agent può essere falsificato. Google e OpenAI, ad esempio, pubblicano gli indirizzi IP ufficiali dei propri crawler per verificarli.
Domande frequenti
Bloccare GPTBot danneggia la SEO su Google?
No. GPTBot è il crawler di OpenAI legato all’addestramento e non ha alcun rapporto con Googlebot. Bloccarlo non influisce sul posizionamento su Google, e nemmeno sulla presenza nella ricerca di ChatGPT, che si gestisce tramite OAI-SearchBot.
Lo stesso principio vale per Google-Extended, che non incide sull’inclusione né sul ranking nella Ricerca Google.
Il robots.txt impedisce l’indicizzazione di una pagina?
No. Il robots.txt impedisce la scansione, non l’indicizzazione. Un URL bloccato può comparire comunque tra i risultati, senza descrizione, se riceve link da altre pagine.
Per escludere davvero una pagina da Google servono il meta tag noindex, la protezione tramite password o la rimozione della pagina.
Un controllo tecnico prima di ogni scelta
Robots.txt, impostazioni della CDN e crawler AI sono ormai un unico sistema: una riga sbagliata può togliere un sito da Google o dalle risposte di ChatGPT senza che nessuno se ne accorga. Per verificare lo stato del vostro sito potete partire dal Flash Audit SEO & GEO gratuito di Eskimoz.
Per costruire una strategia completa di visibilità nei motori di ricerca e nelle IA, l’agenzia GEO di Eskimoz accompagna le aziende dall’audit tecnico alla misurazione delle citazioni.
Need to talk to an expert?
laura.oppizio@eskimoz.it
“`